สรุปข่าว AI ล่าสุด: Jev, Gemini 3.8 Live, Qwen3.8 Omni และ AI ที่เล็กลงแต่เก่งขึ้น
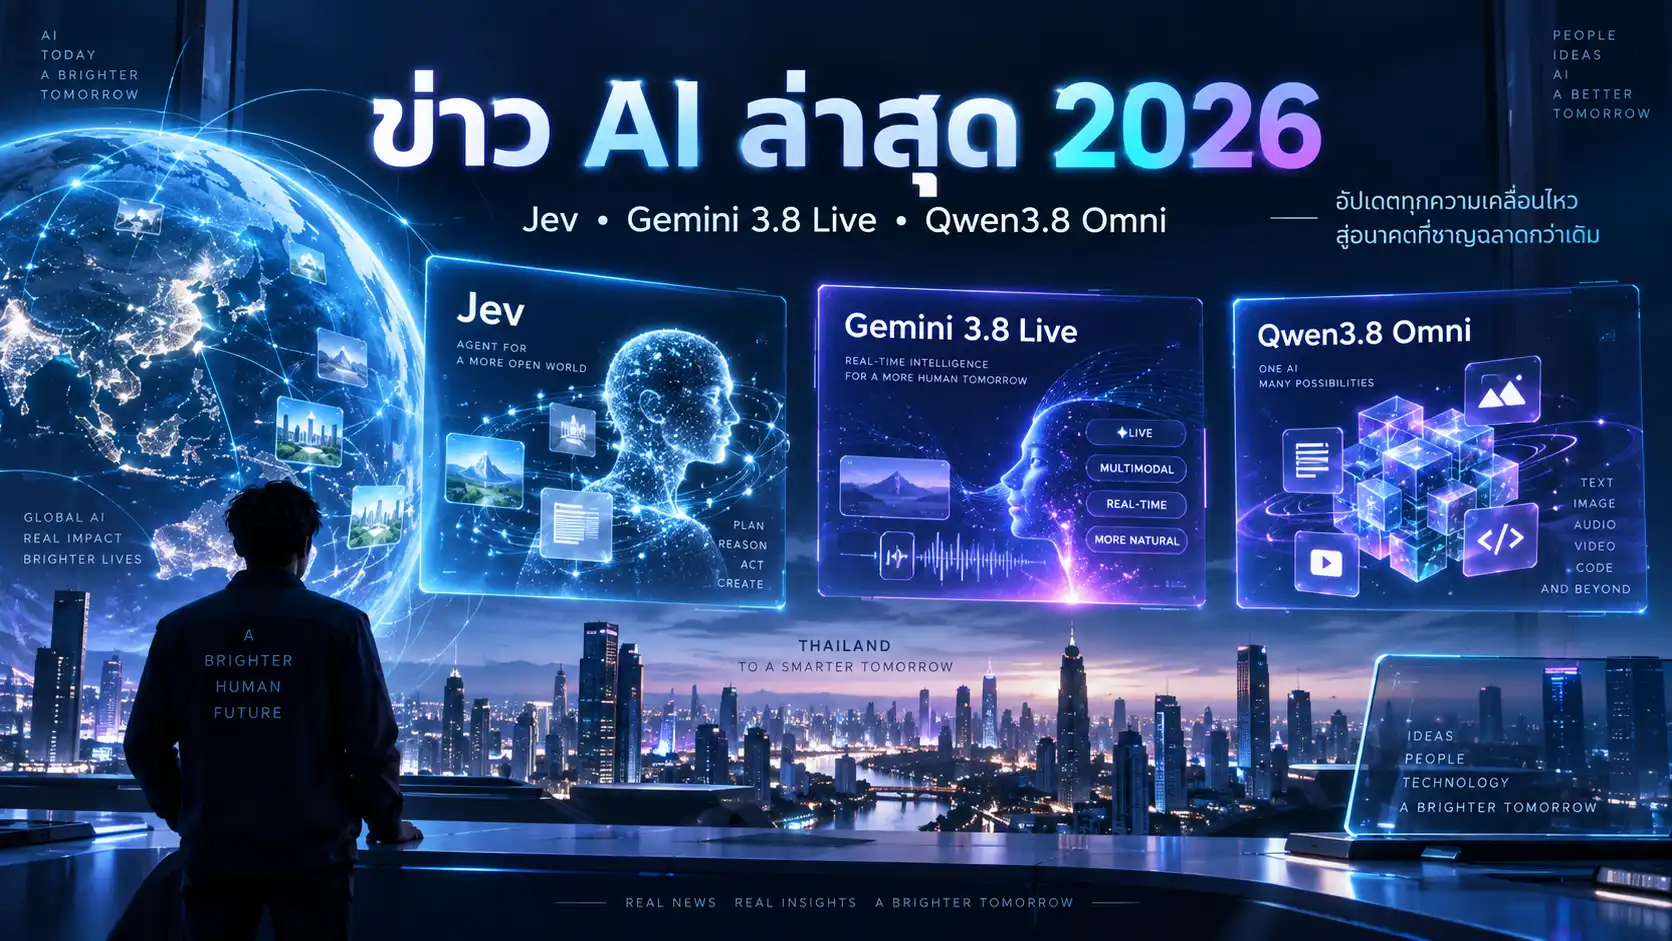
ข่าว AI รอบนี้สะท้อนให้เห็นว่าการแข่งขันไม่ได้มีแค่เรื่อง “โมเดลไหนฉลาดกว่า” แต่กำลังขยายไปถึง AI ที่ตัดสินใจได้เร็วขึ้น, Voice AI ที่สนทนาแบบ Real-time, โมเดล Multimodal ที่รับภาพ เสียง และวิดีโอ รวมถึงเทคนิคที่ทำให้โมเดลขนาดใหญ่เล็กลงจนเข้าใกล้การใช้งานบนเครื่องทั่วไปมากขึ้น
ประเด็นที่ถูกพูดถึงมีตั้งแต่ Jev, Gemini 3.8 Live, Qwen3.8 Omni, Dream-RSI, Bonsai 2 ไปจนถึงการใช้ AI ช่วยงาน Cybersecurity ซึ่งแต่ละเรื่องกำลังชี้ไปคนละด้านของการพัฒนา AI ในปี 2026
6 ประเด็นข่าว AI ที่น่าจับตาในรอบนี้
Jev
AI ที่ไม่ได้เน้นสร้างข้อความยาว แต่เน้นรับข้อมูล แล้วเลือกผลลัพธ์จากตัวเลือกหรือโครงสร้างที่กำหนดไว้ เหมาะกับงาน Routing, Classification และ Workflow Automation ที่ต้องการ Response เร็ว
Gemini 3.8 Live
แนวทาง Voice AI ที่พยายามทำให้การสนทนา การเรียก Tool และการประมวลผลเบื้องหลังเกิดขึ้นอย่างต่อเนื่องมากขึ้น โดยไม่ต้องหยุดบทสนทนาทุกครั้ง
Qwen3.8 Omni
โมเดลในกลุ่ม Omni-modal ที่รองรับข้อมูลหลายประเภท เช่น Text, Image, Audio และ Video เพื่อให้ข้อมูลหลายรูปแบบเข้าสู่ Workflow เดียวกันได้
Bonsai 2 27B
ตัวอย่างของแนวทางบีบอัดโมเดลขนาดใหญ่ ด้วย Ternary Weight เพื่อลดพื้นที่จัดเก็บและทรัพยากรที่ต้องใช้
Dream-RSI
แนวคิดที่ให้ AI นำประวัติการค้นหาวิธีแก้ปัญหา กลับมาใช้เป็นสภาพแวดล้อมสำหรับทดลอง Policy ใหม่ แทนที่จะเริ่มค้นหาจากศูนย์ทุกครั้ง
AI-assisted Security Research
AI เริ่มถูกใช้ช่วยอ่าน Code วิเคราะห์ Dependency และเชื่อมโยงช่องโหว่หลายจุดเข้าด้วยกัน ทำให้ Security Research บางประเภทดำเนินการได้เร็วขึ้น
Jev คืออะไร? ทำไม AI ที่ไม่เน้น “คุย” ถึงน่าสนใจ
AI ที่เราใช้กันทั่วไปอย่าง ChatGPT, Claude หรือ Gemini มักเป็นระบบที่รับ Prompt แล้วสร้างคำตอบออกมาเป็นข้อความทีละ Token
แต่ Jev ถูกนำเสนอในแนวทางที่ต่างออกไป คือเน้นรับข้อมูลแล้วเลือกผลลัพธ์จาก Schema หรือ Choice ที่ระบบกำหนดไว้ล่วงหน้า แทนที่จะสร้างคำตอบแบบอิสระ
ตัวอย่างเช่น ระบบ Customer Support อาจกำหนดตัวเลือกไว้ว่า Sales, Billing, Technical Support และ Spam จากนั้นให้โมเดลเลือกว่าข้อความใหม่ควรถูกส่งไปทางใด
หากโมเดลถูกบังคับให้ตอบเฉพาะ Choice หรือ Schema ที่กำหนดไว้ มันจะไม่สามารถสร้าง Output นอกกรอบนั้นเหมือน Generative AI ทั่วไป แต่ไม่ได้หมายความว่าโมเดลจะเลือกคำตอบที่ถูกต้อง 100%
โมเดลยังสามารถ Classify ผิดหรือเลือก Action ผิดได้ ดังนั้นงานที่มีความเสี่ยงยังควรมี Threshold, Monitoring และ Human Review ตามความเหมาะสม
งานแบบไหนที่ AI ลักษณะนี้น่าสนใจ?
แนวคิดสำคัญคือระบบ AI ในอนาคตอาจไม่ได้ใช้ LLM ขนาดใหญ่ตัวเดียวทำทุกอย่าง แต่แบ่งหน้าที่ให้โมเดลแต่ละประเภท เช่น โมเดลหนึ่งใช้ Reasoning, อีกโมเดลใช้ตัดสินใจ, อีกตัวใช้ตรวจ Output และอีกตัวรับผิดชอบ Voice หรือ Vision
Gemini 3.8 Live และการแข่งขันของ Voice AI
ข้อจำกัดของ Voice Assistant รุ่นแรก ๆ คือ หลังจากผู้ใช้พูดจบ ระบบต้องรอประมวลผล อาจต้องเรียก API หรือค้นข้อมูล ก่อนจะกลับมาตอบเป็นเสียง
เมื่อกระบวนการนี้ใช้เวลานาน ผู้ใช้จะรู้สึกถึงช่วงเงียบระหว่างการสนทนาได้ชัดเจน
ข่าวเกี่ยวกับ Gemini 3.8 Live จึงน่าสนใจตรงการพยายามทำให้การสนทนา และการทำงานเบื้องหลังเกิดขึ้นควบคู่กันมากขึ้น
Voice AI แบบเดิม
- รับเสียงจากผู้ใช้
- หยุดเพื่อประมวลผล
- เรียก Tool หรือ API
- รอผล
- จึงค่อยตอบกลับ
ทิศทาง Voice AI รุ่นใหม่
- รักษาบริบทระหว่างการพูด
- จัดการ Interrupt ได้ดีขึ้น
- เรียก Tool ระหว่าง Workflow
- ลดช่วงเวลาที่ผู้ใช้ต้องรอ
- ทำให้ Turn Taking เป็นธรรมชาติมากขึ้น
ทำไม Latency สำคัญกับ Voice AI?
ใน Chat ผู้ใช้อาจยอมรอคำตอบสองหรือสามวินาทีได้ แต่ในการคุยด้วยเสียง ความเงียบเพียงเล็กน้อย ก็ทำให้รู้สึกได้ว่ากำลังคุยกับระบบที่ “หยุดคิด”
การแข่งขันของ Voice AI จึงไม่ได้มีแค่เรื่องตอบถูกหรือผิด แต่รวมถึง Latency, Turn Taking, Interruptibility, Tool Calling และ Context Management ด้วย
Qwen3.8 Omni: เมื่อ AI รับข้อมูลมากกว่าข้อความ
อีกทิศทางที่ชัดเจนคือโมเดลประเภท Omni-modal ซึ่งไม่ได้รับเฉพาะข้อความ แต่สามารถนำข้อมูลประเภทอื่นเข้าสู่ Context เดียวกันได้
ประโยชน์ของแนวคิดนี้เห็นได้ง่ายในงานอย่าง การสรุป Meeting ที่มีทั้งเสียง Slide และเอกสารประกอบ หรือการวิเคราะห์วิดีโอพร้อม Transcript โดยไม่ต้องแยกทุกอย่างเป็น Pipeline คนละระบบตั้งแต่ต้น
จำนวน Token ที่รองรับคือขนาดข้อมูลที่สามารถใส่เข้าไปได้ แต่ความสามารถในการค้นหา เชื่อมโยง และตีความรายละเอียด ยังขึ้นกับโมเดล Prompt และลักษณะข้อมูลด้วย
Bonsai 2 27B: ทำไมการลดขนาดโมเดลจึงสำคัญ?
อีกสายหนึ่งไม่ได้พยายามเพิ่มจำนวนพารามิเตอร์ แต่พยายามทำให้โมเดลเดิมใช้พื้นที่และทรัพยากรน้อยลง
Bonsai 2 27B ถูกพูดถึงในบริบทของเทคนิค Ternary Weight ซึ่งลด Weight หลักให้อยู่ในชุดค่าที่ง่ายขึ้น เช่น -1, 0 และ +1 ร่วมกับ Scaling
รายการ | โมเดลเดิม | Bonsai 2 27B |
|---|---|---|
ระดับโมเดล | 27B class | 27B class |
Weight Format | ความละเอียดสูงกว่า | Ternary + Scaling |
ขนาด | ระดับหลายสิบ GB ในบาง Format | ลดลงอย่างมากตามข้อมูลที่ผู้พัฒนารายงาน |
เป้าหมาย | ประสิทธิภาพของโมเดลต้นฉบับ | ลด Memory และ Storage Requirement |
ถ้าแนวทางเหล่านี้พัฒนาได้ดีขึ้น AI ระดับหลายหมื่นล้านพารามิเตอร์อาจเข้าใกล้ Consumer Hardware หรือ Edge Device มากขึ้น
สิ่งนี้มีความหมายกับองค์กรที่ต้องการ ลดการส่งข้อมูลขึ้น Cloud หรือทดลอง Local AI ในระบบภายใน
หากผู้พัฒนาระบุว่าโมเดลบีบอัดรักษาประสิทธิภาพได้เป็นเปอร์เซ็นต์สูง ตัวเลขดังกล่าวควรอ่านร่วมกับ Benchmark, Dataset, Runtime และ Hardware ที่ใช้ทดสอบ
ไม่ควรตีความว่าโมเดลบีบอัด จะให้ผลเหมือนโมเดลต้นฉบับทุก Task
Dream-RSI คืออะไร?
อีกประเด็นที่น่าสนใจคือแนวทาง Recursive Self-Improvement ที่ไม่ได้หมายความว่า AI สามารถแก้ตัวเองแล้วฉลาดขึ้นแบบไม่มีขอบเขต
หนึ่งในแนวคิดที่ถูกพูดถึงคือ การเก็บเส้นทางที่ Agent เคยลองแก้ปัญหา เป็นโครงสร้างลักษณะ Discovery Tree แล้วนำข้อมูลนั้นกลับมาใช้ในการทดลอง Policy ใหม่
ประโยชน์ของแนวคิดนี้คือ การทดลองบางอย่างอาจไม่จำเป็นต้องเริ่มต้นใหม่กับ Environment จริงทุกครั้ง ทำให้ประสบการณ์เดิมของ Agent กลายเป็นข้อมูลสำหรับการค้นหาแนวทางใหม่ต่อ
AI กับ Cybersecurity: ทำไมข่าวนี้ควรจับตา?
AI เริ่มถูกใช้เป็นเครื่องมือในงาน Security Research เช่นอ่าน Code, วิเคราะห์ Library, ค้นหา Dependency และช่วยเชื่อมโยงช่องโหว่หลายจุดเข้าด้วยกัน
เมื่อเครื่องมือเหล่านี้ช่วยลดเวลาในการวิเคราะห์ ทีม Security ขนาดเล็กก็สามารถตรวจสอบระบบซับซ้อนได้เร็วขึ้น
ด้านการป้องกัน
- ช่วย Review Code
- ช่วยค้นหา Vulnerability
- วิเคราะห์ Log และ Trace
- ช่วยจัดลำดับสิ่งที่ควรตรวจสอบ
ด้านความเสี่ยง
- ลดต้นทุนการวิเคราะห์ระบบ
- ช่วยค้นหา Attack Surface ได้เร็วขึ้น
- ทำให้การเชื่อมโยงข้อมูลจำนวนมากง่ายขึ้น
- องค์กรต้องควบคุม Permission และ Monitoring มากขึ้น
งาน Security Research, Bug Bounty, Responsible Disclosure และเหตุการณ์ที่มีผู้โจมตีจริง เป็นคนละลักษณะเหตุการณ์
ดังนั้นเวลาอ่านข่าว Cybersecurity ควรดูว่าใครเป็นผู้ค้นพบช่องโหว่ มีการเข้าถึงข้อมูลจริงหรือไม่ และเหตุการณ์เกิดใน Environment แบบใด ก่อนสรุปว่าองค์กรถูกเจาะระบบในความหมายเดียวกันทั้งหมด
เมื่อมองรวมกัน ข่าว AI รอบนี้กำลังบอกอะไร?
ทิศทาง | ตัวอย่าง | สิ่งที่น่าสนใจ |
|---|---|---|
Decision AI | Jev | งานบางประเภทไม่จำเป็นต้องใช้ Generative LLM สร้างข้อความ |
Real-time Voice | Gemini Live | Voice Agent กำลังลดช่องว่างระหว่างการพูดกับการเรียก Tool |
Omni-modal AI | Qwen Omni | Text, Image, Audio และ Video เข้า Workflow เดียวกันมากขึ้น |
Model Compression | Bonsai | โมเดลใหญ่เริ่มมีโอกาสรันบน Hardware ที่เข้าถึงง่ายขึ้น |
Agent Improvement | Dream-RSI | ประสบการณ์เดิมของ Agent ถูกนำกลับมาใช้กับการค้นหา Policy ใหม่ |
AI Security | AI-assisted Research | เวลาและต้นทุนของ Security Analysis บางประเภทลดลง |
ธุรกิจควรมองข่าว AI เหล่านี้อย่างไร?
ไม่จำเป็นต้องเปลี่ยนระบบทุกครั้งที่มี AI รุ่นใหม่เปิดตัว เพราะโมเดลแต่ละประเภทถูกออกแบบมาสำหรับปัญหาต่างกัน
ก่อนเลือก AI ควรถามก่อนว่า Input คืออะไร, Output ต้องการรูปแบบไหน, ความผิดพลาดยอมรับได้เท่าไร, ข้อมูลสามารถออกไปภายนอกได้หรือไม่ และจุดใดต้องให้มนุษย์เป็นผู้ตัดสินใจ
โมเดลที่ใหม่กว่าไม่ได้แก้ Workflow ที่ยังไม่มี Requirement ชัดเจนโดยอัตโนมัติ
FAQ: ข่าว AI ล่าสุดและโมเดลที่ถูกพูดถึง
Jev คืออะไร?
Jev ถูกนำเสนอเป็น AI สำหรับงานตัดสินใจจากตัวเลือกหรือ Schema ที่กำหนดไว้ล่วงหน้า มากกว่าการสร้างข้อความยาวแบบ Chatbot ทั่วไป
Jev ไม่มี Hallucination จริงหรือ?
ถ้าระบบบังคับ Output ให้อยู่ใน Choice ที่กำหนด โมเดลจะไม่สร้างข้อความนอกกรอบนั้น แต่ยังสามารถเลือก Choice ที่ไม่ถูกต้องได้ ดังนั้นไม่ได้หมายความว่าการตัดสินใจถูก 100%
Qwen3.8 Omni ใช้กับวิดีโอได้หรือไม่?
แนวคิดของ Omni-modal Model คือรองรับข้อมูลหลายรูปแบบ รวมถึง Text, Image, Audio และ Video แต่ความสามารถจริงต้องดูรายละเอียดของรุ่นและ Interface ที่ผู้ให้บริการเปิดให้ใช้งาน
Context 1 ล้าน Token หมายความว่า AI จำทุกอย่างได้หรือไม่?
ไม่จำเป็น Context Window บอกปริมาณข้อมูลที่สามารถใส่เข้าสู่ Context ได้ แต่ไม่ได้รับประกันว่าโมเดลจะดึงรายละเอียดทุกจุดออกมาได้อย่างถูกต้อง
โมเดลที่ถูกบีบอัดยังเก่งเท่าโมเดลเดิมหรือไม่?
ขึ้นกับวิธีบีบอัด Task และ Hardware Benchmark ของผู้พัฒนาสามารถใช้ประกอบการประเมินได้ แต่ควรทดสอบกับงานจริงก่อน
AI สามารถช่วยค้นหาช่องโหว่ระบบได้จริงหรือไม่?
AI สามารถช่วยอ่าน Code วิเคราะห์ Dependency ค้นหารูปแบบ และช่วยผู้เชี่ยวชาญเชื่อมโยงข้อมูลได้ แต่ผลลัพธ์ยังต้องผ่านการตรวจสอบโดยผู้เชี่ยวชาญด้าน Security
ธุรกิจควรเปลี่ยนไปใช้ AI รุ่นใหม่ทันทีหรือไม่?
ไม่จำเป็น ควรเลือกจาก Requirement, ต้นทุน, Privacy, Latency, Workflow และระดับความเสี่ยงของงานมากกว่าดูเพียงชื่อโมเดลหรือ Benchmark
แหล่งข้อมูลและหมายเหตุการเรียบเรียง
บทความนี้เรียบเรียงจากประเด็นข่าวและข้อมูลในวิดีโอ OpenAI hacked, Jev, Google’s RSI, Qwen 3.8 Omni, Bonsai 2, new Gemini Live: AI NEWS รวมถึงข้อมูลที่เกี่ยวข้องกับผลิตภัณฑ์และงานวิจัยที่กล่าวถึง
- ดูวิดีโอต้นทางบน YouTube
- ตัวเลข Benchmark, Latency, Model Size และข้อความเกี่ยวกับความสามารถของผลิตภัณฑ์บางส่วน อาจเป็นข้อมูลที่ผู้พัฒนาแต่ละรายรายงาน
- ผลการใช้งานจริงอาจแตกต่างกันตาม Model Version, Hardware, Dataset, Prompt และ Configuration
สรุป: AI ปี 2026 กำลังเปลี่ยนจาก “โมเดลเดียวทำทุกอย่าง” ไปสู่ AI ที่แบ่งหน้าที่ชัดขึ้น
ข่าว Jev, Gemini Live, Qwen Omni, Bonsai และ Dream-RSI แม้จะดูเป็นเรื่องคนละประเภท แต่มีจุดร่วมอย่างหนึ่งคือ AI เริ่มถูกออกแบบให้เหมาะกับหน้าที่เฉพาะมากขึ้น
บางระบบเน้นความเร็วในการตัดสินใจ บางโมเดลเน้นการสนทนาด้วยเสียง บางรุ่นรับข้อมูลหลายรูปแบบ ขณะที่อีกกลุ่มพยายามลดขนาดโมเดล หรือทำให้ Agent ใช้ประสบการณ์เดิมได้ดีขึ้น
ดังนั้นคำถามสำคัญสำหรับผู้ใช้งานและธุรกิจ อาจไม่ใช่เพียงว่า “AI ตัวไหนเก่งที่สุด” แต่ควรเป็นว่า งานที่เราต้องการทำจริง ๆ ต้องการ AI แบบไหน และควรวาง Human Review, Privacy, Security และ Workflow ไว้ตรงไหน